در گفتوگو با آناتک بیان شد


بر اساس اعلام شورای اجرایی فناوری اطلاعات:

هوش مصنوعی اوپنایآی طراحی تراشههای پرچمدار AMD را تا ۱۴ درصد بهبود داد
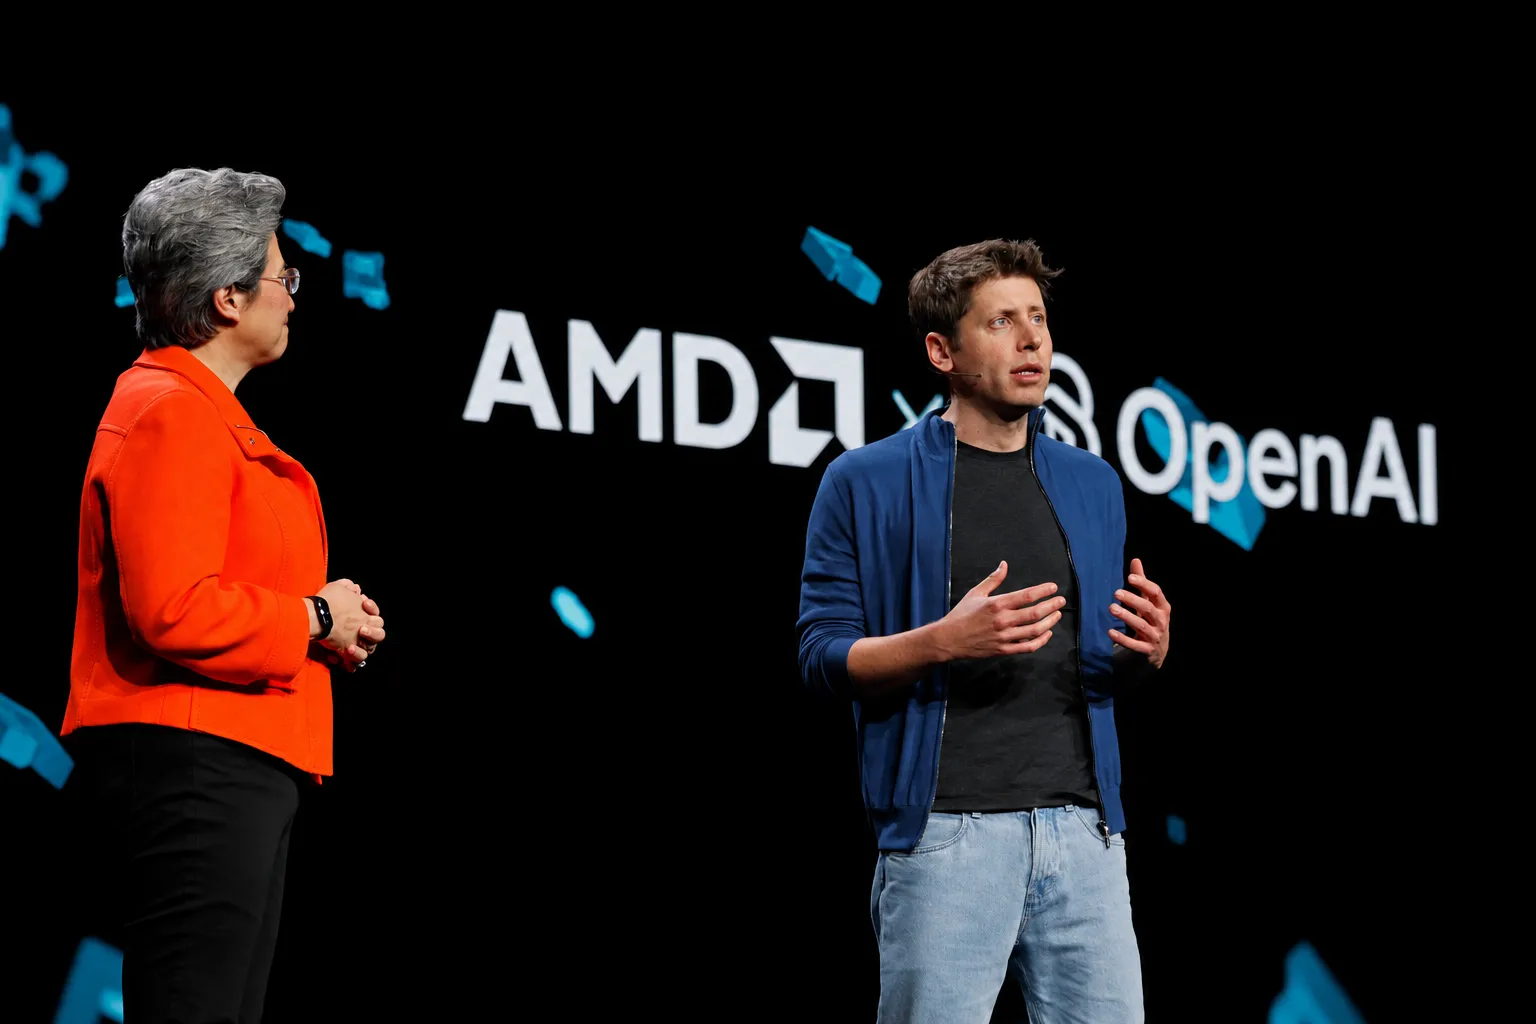

به گزارش خبرگزاری آنا؛ مهندسان اوپنایآی و AMD از مدلهای هوش مصنوعی برای بهینهسازی مدارهای پردازندههای نسل بعد استفاده کردهاند و بخشی از اصلاحات پیشنهادی این مدلها اکنون به طراحیهای واقعی تراشه راه یافته است. این همکاری بر تحلیل و بازنویسی کدهایی متمرکز بوده که نحوه عملکرد اجزای داخلی پردازنده را مشخص میکنند. هدف این است که مدارها همان محاسبات قبلی را با مصرف انرژی کمتر، سرعت بیشتر یا فضای کوچکتری انجام دهند، بدون آنکه دقت و درستی عملکرد آنها تغییر کند. اوپنایآی میگوید مدلهایش حتی در طراحیهایی که پیشتر توسط مهندسان باتجربه بهینه شده بودند، توانستهاند روشهای تازهای برای بهبود پیدا کنند. اهمیت این دستاورد تنها به تولید کد جدید محدود نمیشود، زیرا برخی تغییرات پس از بررسیهای فنی در طراحیهای آماده تولید AMD نیز به کار گرفته شدهاند.
طراحی پردازندههای پیشرفته به مجموعهای از تصمیمهای پیچیده وابسته است که هرکدام میتوانند بر عملکرد بخشهای دیگر تأثیر بگذارند. برای مثال، افزایش سرعت یک مدار ممکن است به مصرف انرژی بیشتر یا استفاده از تعداد بالاتری ترانزیستور نیاز داشته باشد، در حالی که کوچکتر کردن همان مدار میتواند محدودیتهایی برای سرعت پردازش ایجاد کند. مهندسان معمولاً گزینههای مختلف را طراحی و آزمایش میکنند تا ترکیب مناسبی از این ویژگیها به دست آورند؛ فرایندی که در تراشههای امروزی به زمان و منابع محاسباتی قابلتوجهی نیاز دارد. مدلهای هوش مصنوعی میتوانند تعداد زیادی از روشهای جایگزین را پیشنهاد دهند و پس از دریافت نتایج آزمایش، طراحی خود را اصلاح کنند. البته بهبودهای اعلامشده به بخشهای مشخصی از مدار مربوط هستند و نباید آنها را معادل افزایش ۱۴ درصدی سرعت یک کارت گرافیک کامل یا عملکرد بازیها در نظر گرفت.
بهبود ۱۴ درصدی طراحی مدارهای پردازنده گرافیکی AMD
مهمترین نتیجه این همکاری به بهینهسازی بخشهایی از پردازنده گرافیکی پرچمدار آینده AMD مربوط میشود که در آن بهبودهایی تا سقف ۱۴ درصد در شاخصهای PPA به دست آمده است. این شاخص مجموعهای از ۳ معیار مصرف انرژی، عملکرد و مساحت مدار را در بر میگیرد و یکی از روشهای اصلی ارزیابی کیفیت طراحی تراشههای نیمههادی محسوب میشود. برای مثال، اگر یک مدار بتواند عملیات مشخصی را با تعداد کمتری از عناصر منطقی انجام دهد، ممکن است فضای کوچکتری روی تراشه اشغال کند. در حالت دیگر، تغییر مسیر انتقال داده یا ترتیب اجرای عملیات میتواند سرعت مدار را افزایش دهد یا انرژی موردنیاز آن را کاهش دهد. چنین اصلاحاتی در مقیاس یک تراشه بزرگ اهمیت دارند، زیرا پردازندههای پیشرفته از مجموعه گستردهای از مدارهای بههمپیوسته تشکیل شدهاند. با این حال، اوپنایآی هنوز مشخص نکرده که سهم هر معیار از بهبود ۱۴ درصدی چقدر بوده و کدام بخشهای پردازنده گرافیکی بیشترین پیشرفت را تجربه کردهاند.
دستیابی به این مقدار بهبود در شرایطی انجام شده که طراحیهای اولیه AMD پیشتر توسط متخصصان انسانی بهطور گسترده بررسی و اصلاح شده بودند. در مراحل ابتدایی طراحی معمولاً فرصتهای آشکارتری برای کاهش مصرف انرژی یا حذف اجزای اضافی وجود دارد، اما با پیشرفت بهینهسازی، یافتن تغییرات مؤثر دشوارتر میشود. مدلهای هوش مصنوعی با بررسی روابط منطقی میان اجزای مدار، ساختارهایی را پیشنهاد کردهاند که همان عملیات را به شیوه متفاوتی انجام میدهند. برای نمونه، ممکن است چند بخش از یک مدار بتوانند از منابع مشترکی استفاده کنند یا یک محاسبه با تعداد مراحل کمتری انجام شود. چنین تغییراتی در صورت تأیید مهندسان میتوانند به طراحی نهایی راه پیدا کنند، اما اثر آنها بر محصول کامل به نحوه ترکیب مدارها و محدودیتهای سایر اجزای پردازنده بستگی دارد. به همین دلیل، رقم ۱۴ درصد فعلاً باید بهعنوان دستاوردی در سطح طراحی مدار ارزیابی شود، نه معیاری برای پیشبینی عملکرد نهایی پردازنده گرافیکی.
پردازنده مرکزی نسل بعدی نیز بهینهسازی شد
همکاری ۲ شرکت به پردازندههای گرافیکی محدود نبوده و بخشهایی از پردازنده مرکزی پرچمدار نسل بعدی AMD نیز با کمک هوش مصنوعی اصلاح شدهاند. اوپنایآی اعلام کرده که AMD بهبودهای تکرقمی در شاخصهای PPA برخی بلوکهای مهم این پردازنده را بررسی و تأیید کرده است. هرچند این میزان کمتر از پیشرفت اعلامشده برای پردازنده گرافیکی است، اما حتی تغییرات کوچک نیز میتوانند در طراحی مدارهایی که بارها در ساختار یک پردازنده تکرار میشوند، اهمیت داشته باشند. برای مثال، کاهش فضای اشغالشده توسط یک مدار تکرارشونده میتواند به استفاده بهینهتر از سطح تراشه کمک کند و کاهش مصرف انرژی آن نیز ممکن است در مجموعهای بزرگتر اثر محسوسی داشته باشد. با این حال، شرکت هنوز درصد دقیق بهبود، نوع بلوکهای بهینهشده و معماری پردازنده را معرفی نکرده است و اطلاعات کافی برای برآورد تأثیر این اصلاحات بر سرعت اجرای نرمافزارها یا مصرف انرژی محصول نهایی وجود ندارد.
بخشی از اهمیت پروژه به عبور اصلاحات پیشنهادی از مرحله آزمایش مربوط میشود. AMD برخی تغییرات ایجادشده با کمک هوش مصنوعی را در طراحیهایی قرار داده که برای ساخت به کارخانه ارسال شدهاند و اصلاحات دیگری نیز وارد فایلهای تولیدی شرکت شدهاند. در صنعت نیمههادی، رسیدن یک طراحی به این مرحله اهمیت زیادی دارد، زیرا مدار باید پیش از ساخت از نظر درستی عملکرد، محدودیتهای زمانی و سازگاری با سایر بخشهای تراشه بررسی شود. طرحی که در یک آزمایش جداگانه نتیجه خوبی به دست میآورد، ممکن است پس از قرار گرفتن کنار دهها مدار دیگر با محدودیتهای تازهای روبهرو شود. بنابراین، مهندسان باید اطمینان پیدا کنند که مزیت بهدستآمده در شرایط واقعی طراحی نیز قابل استفاده است. با وجود پیشرفت پروژه، اوپنایآی هنوز مشخص نکرده این اصلاحات در کدام محصولات تجاری AMD به کار گرفته شدهاند یا چه زمانی پردازندههای مرتبط وارد بازار خواهند شد.
بازنویسی کدهای SystemVerilog مسیر بهینهسازی را تغییر داد
مدلهای هوش مصنوعی برای اصلاح مدارها، کدهای توصیف سختافزار را در سطح انتقال ثبات یا RTL بازنویسی کردهاند. این کدها با زبان SystemVerilog نوشته میشوند و به زبان ساده، نحوه جابهجایی دادهها و انجام محاسبات در بخشهای داخلی پردازنده را مشخص میکنند. تفاوت مهم این کدها با برنامههای نرمافزاری معمولی آن است که هدف از نوشتن آنها اجرای مستقیم دستورها توسط یک پردازنده نیست، بلکه توصیف مداری است که بعداً در قالب سختافزار ساخته خواهد شد. برای مثال، مهندس میتواند عملیات جمع یا ضرب را با چند ساختار منطقی متفاوت توصیف کند که همگی نتیجه یکسانی تولید میکنند، اما از نظر سرعت، مصرف انرژی و تعداد اجزای موردنیاز یکسان نیستند. هوش مصنوعی با بررسی چنین تفاوتهایی تلاش میکند ساختاری پیدا کند که اجرای همان عملیات را با منابع کمتری امکانپذیر سازد.
اوپنایآی معتقد است مدلهایش در این پروژه توانستهاند کدهای RTL را در سطحی تحلیل کنند که به دانش یک متخصص باتجربه ریزمعماری نیاز دارد. مدلها تنها نام متغیرها یا شکل ظاهری کد را تغییر ندادهاند، بلکه درباره ارتباط اجزای داخلی مدار، مسیر حرکت دادهها و روش اجرای عملیات پیشنهادهای تازهای ارائه کردهاند. البته هر بازنویسی باید پیش از استفاده در طراحی واقعی آزمایش شود، زیرا حتی یک تغییر کوچک ممکن است در شرایط خاص باعث محاسبه اشتباه شود. برای جلوگیری از چنین مشکلاتی، مهندسان از ابزارهای تخصصی طراحی الکترونیکی برای مقایسه عملکرد نسخه اصلی و نسخه اصلاحشده استفاده میکنند. این ابزارها بررسی میکنند که هر ۲ طراحی در شرایط موردنظر خروجی یکسانی تولید کنند و سپس تأثیر تغییرات بر سرعت، مصرف انرژی و مساحت مدار را ارزیابی میکنند. در نتیجه، نقش هوش مصنوعی بیشتر به ارائه گزینههای تازه و سرعت بخشیدن به جستوجوی طراحی مناسب مربوط میشود و تأیید نهایی همچنان به آزمایشهای مهندسی وابسته است.
یک سال پیشرفت مهندسی در کمتر از ۵ ماه حاصل شد
اوپنایآی مدعی است اصلاحات انجامشده در پروژه AMD از نظر میزان پیشرفت طراحی، با حدود یک سال کار مهندسی به روشهای متداول برابری میکنند، در حالی که دستیابی به آنها کمتر از ۵ ماه زمان برده است. این مقایسه به فرایند بهینهسازی مدارها مربوط میشود و نباید آن را به معنای کاهش زمان توسعه کامل یک پردازنده از یک سال به ۵ ماه تفسیر کرد. ساخت یک تراشه پیشرفته مراحل متعددی دارد که از طراحی معماری و مدارهای منطقی آغاز میشود و تا بررسی زمانبندی، طراحی فیزیکی، ساخت نمونه و آزمایش تراشه ادامه پیدا میکند. مدلهای هوش مصنوعی میتوانند در بخشی از این مسیر، یافتن راهکارهای تازه را سریعتر کنند. برای مثال، بهجای آنکه یک مهندس چندین روز صرف طراحی و بررسی تعدادی ساختار جایگزین کند، مدل میتواند گزینههای مختلفی پیشنهاد دهد تا تیم فنی بر آزمایش و انتخاب موارد مناسب تمرکز کند.
کاهش زمان بهینهسازی میتواند به سازندگان تراشه امکان دهد پیش از نهایی کردن طراحی، تعداد بیشتری از گزینهها را بررسی کنند. این مزیت در صنعت نیمههادی اهمیت زیادی دارد، زیرا تغییر در مدار پس از آغاز ساخت نمونههای سیلیکونی معمولاً بهمراتب پرهزینهتر و زمانبرتر از اصلاح کد در مراحل اولیه است. اوپنایآی همچنین انتظار دارد مدلهای جدید بتوانند طراحیهایی را که اکنون بهینه شدهاند، بار دیگر بررسی کنند و اصلاحات بیشتری پیشنهاد دهند. با این حال، میزان پیشرفت در هر مرحله لزوماً ثابت نخواهد بود، زیرا هرچه طراحی به محدودیتهای فیزیکی و عملکردی نزدیکتر شود، یافتن فرصتهای جدید دشوارتر میشود. این شرکت هنوز روش کامل محاسبه معادل یک سال پیشرفت مهندسی را برای ارزیابی مستقل منتشر نکرده است و رقم کمتر از ۵ ماه نیز براساس برآورد ارائهشده توسط خود اوپنایآی مطرح میشود.
تجربه ساخت تراشه اختصاصی هالاپینو به همکاری با AMD کمک کرد
اوپنایآی پیش از آغاز همکاری اخیر، تجربه استفاده از مدلهای هوش مصنوعی در طراحی تراشه اختصاصی استنتاج خود با نام Jalapeño را به دست آورده بود. این پردازنده با همکاری برودکام توسعه یافته و برای اجرای مدلهای هوش مصنوعی با مصرف انرژی و تأخیر کمتر طراحی شده است. استفاده از مدلهای زبانی در بهینهسازی مدارهای آن از اوایل سال ۲۰۲۵ آغاز شد و حتی مدل GPT-o۳ mini توانسته بود برخی فرصتهای غیرساده برای اصلاح طراحی پیدا کند. تیم مهندسی این پروژه روی واحدهای محاسبات برداری و ماتریسی تمرکز داشت؛ بخشهایی که عملیات ریاضی موردنیاز برای اجرای شبکههای عصبی را انجام میدهند. از آنجا که مدلهای هوش مصنوعی برای پردازش دادهها بارها از این عملیات استفاده میکنند، کاهش هزینه اجرای هر محاسبه میتواند در مقیاس یک شتابدهنده بزرگ اهمیت داشته باشد.
در واحد محاسبات برداری این تراشه، اصلاحات پیشنهادی به کاهش حدود ۱۳ درصدی مساحت سلولهای استاندارد منجر شده و میزان کاهش در واحد محاسبات ماتریسی نیز نزدیک به ۱۰ درصد بوده است. یکی از نمونههای مهم به مدار ضرب مربوط میشود که پس از بازطراحی، حدود ۱۵ درصد فضای کمتری اشغال میکرد و تأخیر اجرای عملیات آن از ۲ چرخه کلاک به یک چرخه کاهش یافته بود. به زبان ساده، این مدار میتوانست همان محاسبه را در مراحل زمانی کمتری انجام دهد و در عین حال کوچکتر باشد. در نمونه دیگری، مدار جمعکننده بدون تغییر تأخیر ۲ چرخهای خود، نزدیک به ۱۵ درصد کوچکتر شد. این پیشرفتها از تغییر ساختار عملیات ریاضی، استفاده مشترک از بعضی منابع سختافزاری و اصلاح نحوه تقسیم محاسبات میان مراحل پردازشی حاصل شدهاند. اوپنایآی اعلام کرده که بخشی از نتایج پس از ساخت و آزمایش نمونه سیلیکونی نیز تأیید شدهاند و صرفاً به خروجی شبیهسازیهای نرمافزاری محدود نبودهاند.
مدل GPT-۶.۲ Astra در آزمایش طراحی پردازنده پیشتاز شد
پژوهشگران اوپنایآی برای بررسی میزان پیشرفت مدلهای مختلف در طراحی سختافزار، مجموعهای از آزمایشها را با استفاده از ۲ هسته پردازشی متنباز مبتنی بر معماری RISC-V انجام دادهاند. نخستین هسته PicoRV۳۲ نام دارد که طراحی فشردهای داشته و برای استفاده در تراشههای قابلبرنامهریزی FPGA مناسب است. هسته دوم Ibex است که در پروژه امنیتی OpenTitan نیز کاربرد دارد. انتخاب این ۲ طراحی به پژوهشگران اجازه داده عملکرد مدلها را روی کدهای واقعی بررسی کنند، نه صرفاً مسئلههای ساده و آموزشی. در این آزمایش، مدل باید ساختار پردازنده را طوری تغییر میداد که تعداد دستورهای اجراشده در هر ثانیه افزایش پیدا کند، اما نتیجه محاسبات و عملکرد اصلی پردازنده تغییر نکند. برای این منظور، مدلها به کد اصلی دسترسی داشتند و میتوانستند پس از تحلیل بخشهای مختلف، نسخه اصلاحشدهای از طراحی ارائه دهند.
در یکی از شرایط ارزیابی، هر مدل حدود ۱۱۲ هزار توکن برای تحلیل و اصلاح کد در اختیار داشت و طراحی نهایی با مجموعهای از آزمایشهای عملکردی بررسی میشد. اگر کد پیشنهادی باعث میشد پردازنده عملیات را اشتباه انجام دهد یا مساحت مدار از ۱۶ برابر طرح اولیه بیشتر شود، امتیاز آن صفر در نظر گرفته میشد. این محدودیت مانع از آن بود که مدل صرفاً با بزرگتر کردن شدید مدار، به عملکرد بالاتری برسد. برای طراحیهای قابلقبول نیز توان عملیاتی با در نظر گرفتن تعداد دستورهای اجراشده در هر چرخه و فرکانس کلاک تخمینی محاسبه میشد. پژوهشگران همچنین بارهای کاری مورد استفاده در ارزیابی را از مدلها پنهان نگه داشتند تا مدل نتواند فقط برای چند آزمایش شناختهشده بهینه شود. هدف این بود که مشخص شود تغییرات پیشنهادی واقعاً به بهبود طراحی پردازنده کمک میکنند یا تنها در شرایط محدود آزمایش نتیجه مناسبی دارند.
نتایج مقایسه حاکی از برتری GPT-۶.۲ Astra نسبت به مدلهای پیشین در هر ۲ هسته پردازشی بود. این مدل در آزمایش PicoRV۳۲ با بودجه حدود ۱۱۲ هزار توکن، امتیازی نزدیک به ۲ برابر GPT-۶ Astra به دست آورد و در مجموع نیز بالاترین میانگین عملکرد را ثبت کرد. مدل GPT-۶.۱ Sol نیز در آزمایش هر ۲ هسته نسبت به GPT-۵.۶ Sol پیشرفت داشت. این تفاوت میتواند برای طراحی سختافزار اهمیت داشته باشد، زیرا مدل بهتر نهتنها باید کد صحیح تولید کند، بلکه لازم است ساختار مدار را از نظر سرعت و منابع مصرفی نیز بهبود دهد. با این حال، آزمایشهای انجامشده روی هستههای متنباز با فرایند توسعه پردازندههای تجاری تفاوت دارند و موفقیت در آنها لزوماً به معنای دستیابی به همان میزان پیشرفت در طراحیهای بسیار پیچیدهتر نیست. اوپنایآی همچنین مشخص نکرده که دقیقاً از کدام مدل در تمام مراحل همکاری با AMD استفاده شده است.
طراحی پردازنده از مشخصات اولیه نتایج بهتری داشت
پژوهشگران در بخش دیگری از بررسیهای خود، روش متفاوتی را آزمایش کردند که در آن مدل بهجای دریافت کد کامل یک پردازنده، مجموعهای از مشخصات و الزامات فنی را در اختیار داشت. در این روش، هوش مصنوعی باید ساختار داخلی هسته را با رعایت محدودیتهای تعیینشده طراحی میکرد و درباره اجزایی مانند مسیر انتقال داده، واحدهای محاسباتی و مراحل اجرای دستورها تصمیم میگرفت. تفاوت این رویکرد با بازنویسی کد موجود آن است که مدل به ساختار طراحی قبلی وابسته نیست و میتواند برای رسیدن به نتیجه موردنظر، شیوه متفاوتی را انتخاب کند. پژوهشگران شرایط آزمایش، محدودیتهای حافظه و معیارهای ارزیابی را مشابه مرحله قبلی نگه داشتند تا امکان مقایسه فراهم شود. در نهایت، هر ۵ مدل بررسیشده هنگام طراحی هسته از روی مشخصات اولیه، امتیاز بهتری نسبت به زمانی به دست آوردند که مأمور اصلاح یک طراحی موجود بودند. مجموعه کامل ارزیابیها نیز شامل ۹۸۸۱ اجرای امتیازدهیشده بود.
آزادی بیشتر در انتخاب ساختار مدار یکی از دلایل احتمالی این تفاوت محسوب میشود، اما نتایج آزمایش محدودیت مهمی نیز دارند. مدلها هنگام طراحی یک پردازنده از ابتدا ممکن است برخی قابلیتهای غیرضروری برای آزمون را کنار بگذارند تا مدار کوچکتر یا سریعتر شود. برای مثال، حذف شمارندههای عملکرد یا دستورهایی که در بار کاری آزمایش استفاده نمیشوند، میتواند امتیاز طراحی را افزایش دهد، اما چنین پردازندهای ممکن است برای استفاده در یک محصول واقعی مناسب نباشد. در توسعه تجاری، تراشه باید تمام قابلیتهای موردنیاز محصول را حفظ کند و تنها عملکرد مطلوب در چند آزمایش برای تأیید طراحی کافی نیست. پژوهشگران به همین دلیل بر ضرورت تدوین الزامات دقیقتر، استفاده از بارهای کاری متنوع و بررسی زمانبندی پس از طراحی فیزیکی تأکید کردهاند. این اقدامات میتوانند مشخص کنند که توانایی مدلها در تولید معماریهای جدید تا چه اندازه به شرایط واقعی صنعت نیمههادی قابل تعمیم است.
همکاری با سیناپسیس برای توسعه ابزارهای تخصصی ادامه دارد
اوپنایآی در کنار پروژههای مربوط به AMD و تراشه اختصاصی خود، همکاری با شرکت سیناپسیس را برای توسعه مدل تخصصی GPT-Synopsys دنبال میکند. هدف این همکاری ایجاد سامانهای است که بتواند با ابزارهای خودکارسازی طراحی الکترونیکی یا EDA کار کند و بخشی از فرایندهای پیچیده توسعه تراشه را انجام دهد. این ابزارها در مراحل مختلف طراحی مدار استفاده میشوند و میتوانند درستی عملکرد، محدودیتهای زمانی، مصرف انرژی و فضای موردنیاز مدارها را بررسی کنند. ترکیب آنها با مدلهای هوش مصنوعی میتواند فرایندی ایجاد کند که در آن مدل ابتدا یک اصلاح پیشنهاد دهد، نتیجه را با ابزارهای مهندسی آزمایش کند و سپس براساس مشکلات شناساییشده، طرح دیگری ارائه دهد. چنین رویکردی بهویژه برای کارهای تکراری اهمیت دارد، زیرا مهندسان معمولاً ناچارند برای رسیدن به طراحی مناسب، چندین بار میان اصلاح کد و ارزیابی نتیجه جابهجا شوند.
هدف نهایی این همکاری جایگزینی کامل مهندسان سختافزار نیست، بلکه فراهم کردن ابزاری است که بتواند سرعت بررسی گزینههای مختلف را افزایش دهد و فرصتهای بهینهسازی بیشتری پیدا کند. برای مثال، مدل ممکن است در یک مدار پیچیده چند روش برای کاهش مصرف انرژی پیشنهاد دهد، اما ابزارهای تخصصی باید مشخص کنند کدام گزینه با محدودیتهای فنی پروژه سازگار است. مهندسان نیز همچنان مسئول انتخاب ساختار مناسب، بررسی پیامدهای تغییرات و تأیید طراحی پیش از ورود به مراحل تولید خواهند بود. اوپنایآی امیدوار است با توسعه مدلهای تخصصی و اتصال مستقیم آنها به ابزارهای طراحی، این فرایند در پروژههای بیشتری قابل استفاده شود و شرکتهای سازنده تراشه بتوانند بخشی از زمان صرفشده برای بهینهسازی مدارها را کاهش دهند. با این حال، زمان عرضه عمومی GPT-Synopsys، نحوه دسترسی سازندگان تراشه و میزان بهبود عملکرد آن در پروژههای تجاری هنوز اعلام نشده است.
انتهای پیام/